 Data Solutions
Nettoyage des donnees
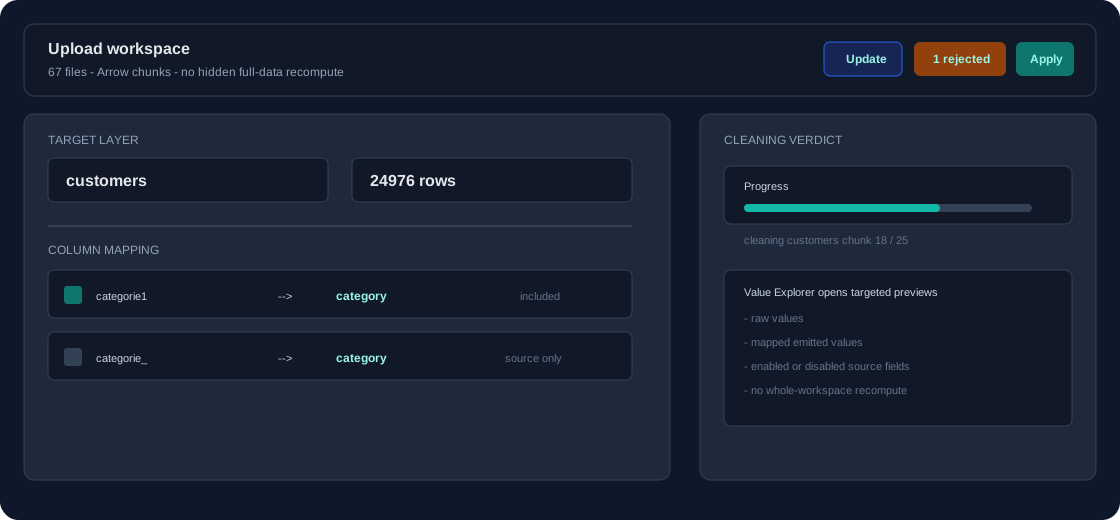
Le nettoyage transforme les fichiers importes en couches utilisables pour la conception. L’espace d’import enregistre vos choix, puis la plateforme applique le verdict.
Ordre de nettoyage
- Lire les donnees importees depuis le stockage du navigateur.
- Appliquer les choix d’inclusion, exclusion et renommage.
- Appliquer les remplacements exacts, y compris
null. - Normaliser les valeurs assimilables a null et appliquer les domaines connus.
- Resoudre les colonnes finales en double avec la source primaire choisie.
- Appliquer les regles de remplissage depuis les valeurs emises.
- Emettre les chunks nettoyes, puis preparer les donnees carte ou edition seulement quand c’est necessaire.
Les colonnes desactivees peuvent rester sources
Desactiver une colonne signifie qu’elle n’est pas emise comme champ final. Cela ne veut pas dire que ses valeurs sont inutiles. Une colonne desactivee peut etre retenue en prive pendant le nettoyage, normalisee par les remplacements et domaines, utilisee par une regle de remplissage, puis supprimee avant la sortie.
Le remplissage utilise les valeurs emises
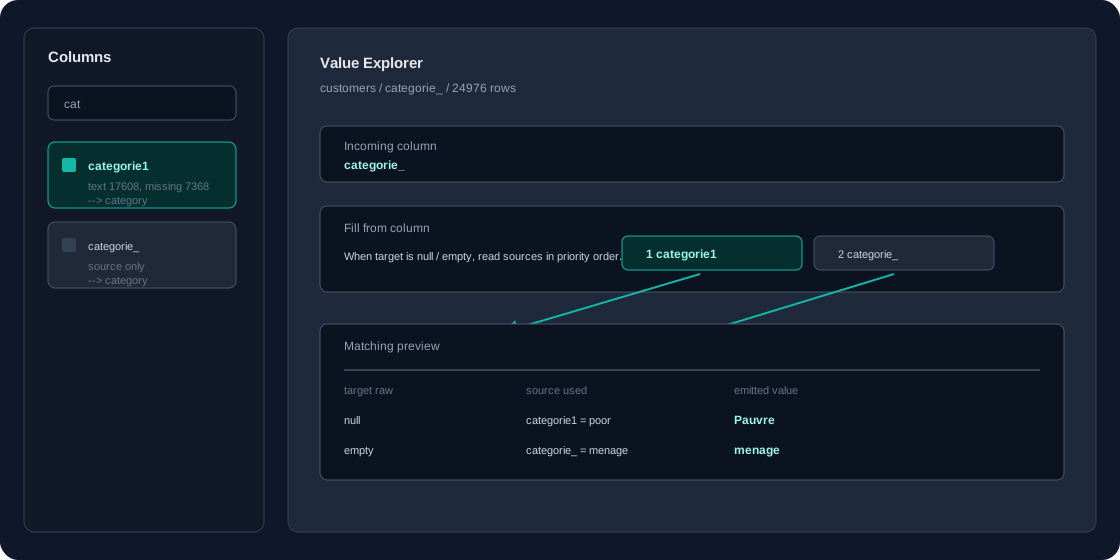
Si cat1 = "poor" est mappe vers Pauvre, alors remplir cat depuis cat1 ecrit Pauvre, pas "poor". La priorite suit l’ordre des sources, et les regles en chaine se stabilisent dans le meme verdict de nettoyage.
Transformer des valeurs en null
Utilisez un remplacement de valeur pour emettre JSON null quand un token n’a pas de sens, par exemple UNKNOWN, N/A ou un code temporaire. Ce null est applique avant les domaines et avant les regles de remplissage, donc une autre source peut reparer la valeur manquante.
Streaming et progression
Les gros imports sont traites par chunks. La progression doit afficher la couche et le chunk courant afin qu’une operation longue ressemble a un travail actif, pas a une page bloquee. Les timeouts sont volontairement longs, car un vrai nettoyage peut prendre plusieurs minutes.